先说现场
Oracle 到 PostgreSQL 不是把表和数据搬过去就结束。真正影响上线的是 schema、序列、数值精度、时间字段和后续增量能力。实施前先确定一个最小范围,用 2 到 3 张典型表跑通完整链路,再扩大表数量。
典型试迁表建议包括:
- 带主键或序列的表。
- 金额、数量等精度敏感字段较多的表。
- 创建时间、更新时间字段齐全的表。
- 字段宽度较大的宽表。
方案怎么选
| 方案 | 适合场景 | 主要限制 |
|---|---|---|
| Canal | MySQL 到下游的增量解析和分发,偏 CDC 链路 | 对 Oracle 支持不是首选,需要维护 MySQL、Kafka、消费端和任务状态 |
| Kettle | 传统 ETL、转换、清洗和报表抽取 | 可视化设计偏流程编排,数据库直连和实时同步能力较弱 |
| DataX | 离线批量同步、一次性全量迁移 | 需要维护 JSON 配置,缺少完整 Web 管理和 CDC 能力 |
| DataMover | 全量、增量字段和 CDC 都需要的私有化同步 | 需要自行部署 Manager、Worker 和元数据库 |
这个场景如果既要 Oracle 全量迁移,又要后续增量字段或 CDC 追平,DataX 更适合做一次性搬迁,DataMover 更适合把全量和后续同步放在同一套可视化管理里。
DataMover 是什么
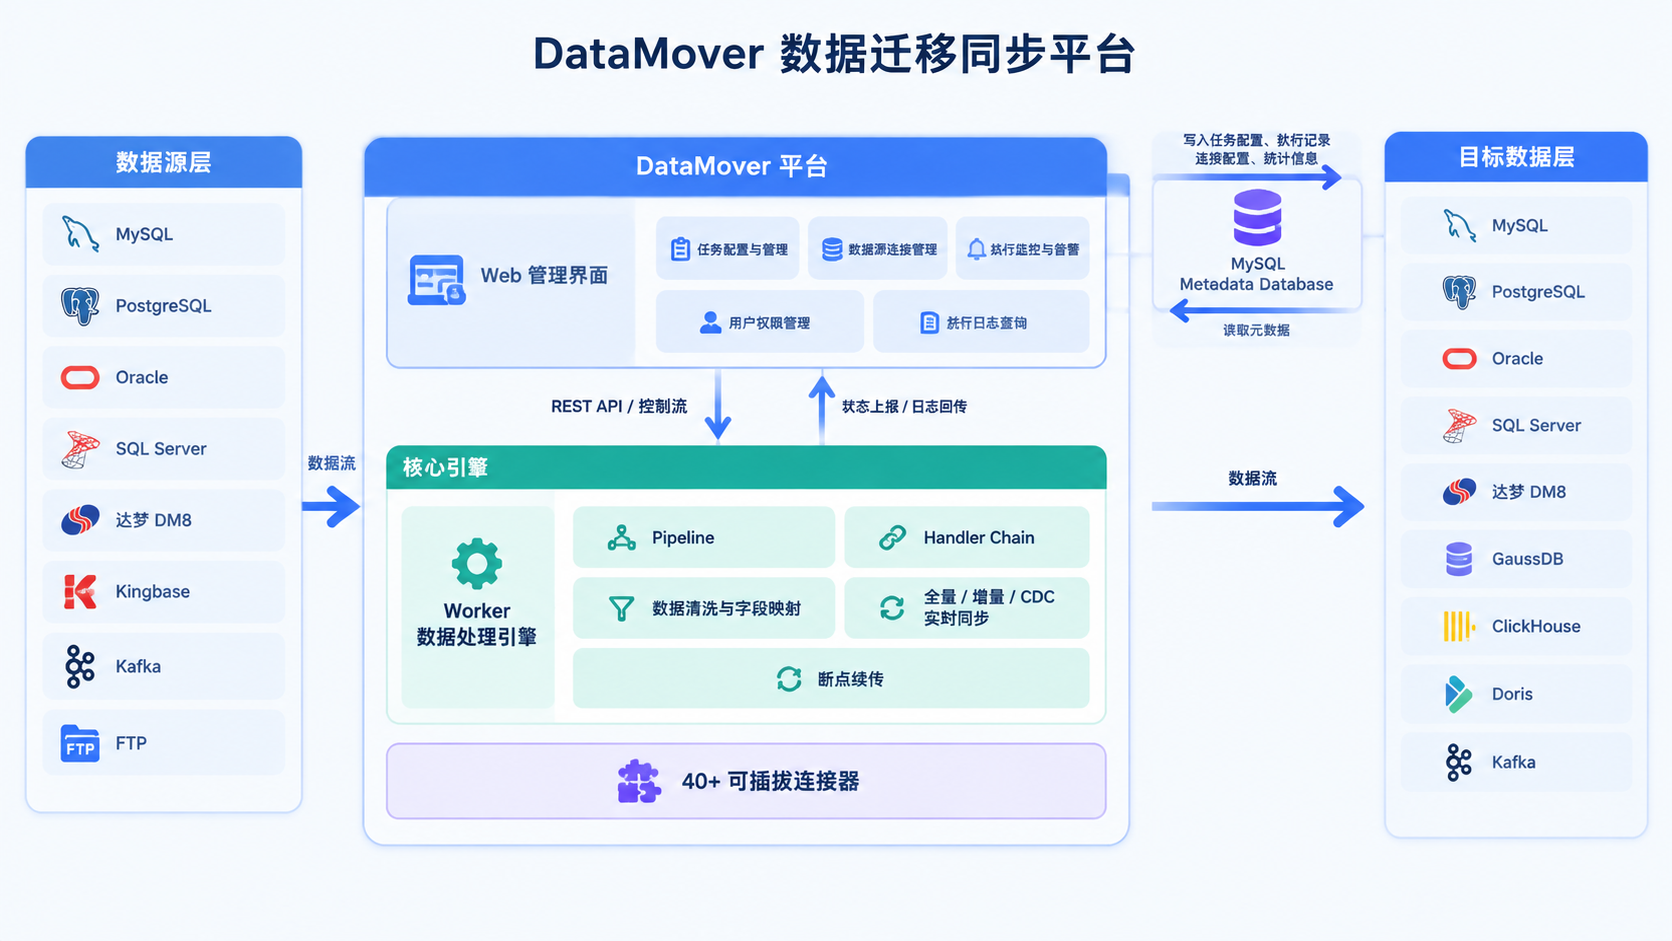
DataMover 是一个私有化部署的数据迁移同步工具,支持普通任务和实时任务:
- 普通任务用于全量同步和基于增量字段的定时同步。
- 实时任务用于 CDC,基于 Oracle LogMiner 等日志能力捕获 INSERT、UPDATE、DELETE。
- Web 界面负责数据源、表映射、字段映射、同步策略和执行监控。
- Manager 负责配置与调度,Worker 负责实际读取、转换和写入。
部署拓扑
建议使用以下最小拓扑:
浏览器
  |
Manager: 8000
  |
Worker: 8011
  |
元数据库:MySQL 5.7+ 或 PostgreSQL 12+
如果使用 Docker 部署,先确认环境中有 Docker Engine 和 Docker Compose。可以用下面的命令快速拉起:
curl -fsSL https://down.datamover.cn/install.sh | bash
安装包和文档入口:
准备阶段:测试表建表和造数
先按下面脚本在 Oracle 源端准备一张测试表,并生成 1 万行数据。目标端 PostgreSQL 的表可以由 DataMover 根据源表自动生成,也可以先按预期结构手工建好,用来核对字段映射。
Oracle 源端测试表
CREATE TABLE dm_demo_user (
  id NUMBER(19) PRIMARY KEY,
  username VARCHAR2(64),
  phone VARCHAR2(32),
  status VARCHAR2(16),
  amount NUMBER(18,2),
  created_at TIMESTAMP,
  updated_at TIMESTAMP
);

INSERT INTO dm_demo_user
SELECT
  LEVEL,
  'user_' || LEVEL,
  '1380000' || LPAD(LEVEL, 4, '0'),
  CASE WHEN MOD(LEVEL, 2) = 0 THEN 'active' ELSE 'inactive' END,
  ROUND(DBMS_RANDOM.VALUE(0, 100000), 2),
  SYSTIMESTAMP,
  SYSTIMESTAMP
FROM DUAL
CONNECT BY LEVEL <= 10000;
COMMIT;
PostgreSQL 目标端预期表结构
CREATE TABLE dm_demo_user (
  id BIGINT PRIMARY KEY,
  username VARCHAR(64),
  phone VARCHAR(32),
  status VARCHAR(16),
  amount NUMERIC(18,2),
  created_at TIMESTAMP,
  updated_at TIMESTAMP
);
源库和目标库权限
| 端 | 需要权限 | 原因 |
|---|---|---|
| Oracle 源端 | 读取表结构、业务数据和元数据;CDC 场景还要日志读取权限 | 数据源连接、选表、字段映射和增量读取 |
| PostgreSQL 目标端 | 建表、写入、更新、删除 | 自动建表和任务写入 |
| 元数据库 | 创建数据库和表权限 | Manager/Worker 保存任务、位点和执行记录 |
| Worker | 能访问源端、目标端和元数据库 | 实际执行任务 |
Oracle CDC 前还需要确认 LogMiner 或归档日志配置,并使用具备复制权限的账号。
Oracle 源端权限检测
SELECT grantee, privilege
FROM dba_sys_privs
WHERE grantee = 'DATAMOVER_USER';

SELECT grantee, granted_role
FROM dba_role_privs
WHERE grantee = 'DATAMOVER_USER';

SELECT grantee, table_name, privilege
FROM dba_tab_privs
WHERE grantee = 'DATAMOVER_USER';
Oracle 源端授权示例
GRANT CONNECT, RESOURCE TO DATAMOVER_USER;
GRANT SELECT ANY TABLE TO DATAMOVER_USER;
GRANT SELECT_CATALOG_ROLE TO DATAMOVER_USER;

GRANT EXECUTE ON DBMS_LOGMNR TO DATAMOVER_USER;
GRANT SELECT ON V_$DATABASE TO DATAMOVER_USER;
GRANT SELECT ON V_$LOG TO DATAMOVER_USER;
GRANT SELECT ON V_$LOGFILE TO DATAMOVER_USER;
GRANT SELECT ON V_$ARCHIVED_LOG TO DATAMOVER_USER;
PostgreSQL 目标端权限检测
SELECT grantee, table_schema, table_name, privilege_type
FROM information_schema.table_privileges
WHERE grantee = 'datamover_target'
ORDER BY table_name, privilege_type;
PostgreSQL 目标端授权示例
CREATE USER datamover_target WITH PASSWORD 'change_me';
CREATE SCHEMA datamover_sync AUTHORIZATION datamover_target;
GRANT ALL ON SCHEMA datamover_sync TO datamover_target;
DataMover 配置选择和内存配置
第一轮实施不要一次把所有参数都调大。先跑通,再根据 Worker 和目标端表现调优。
| 配置 | 建议 | 说明 |
|---|---|---|
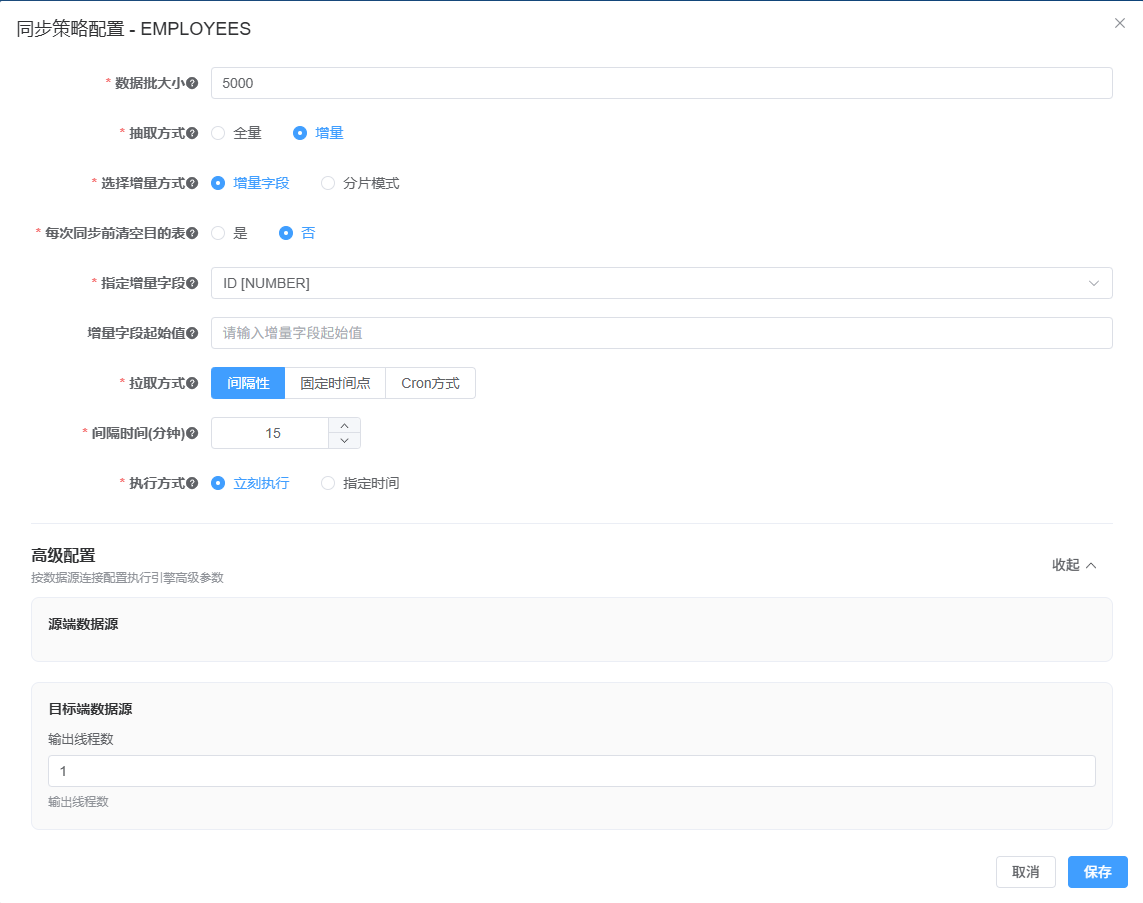
| 数据批大小 | 默认 5000,先保持不变 | 大批量时可按测试结果调整,不超过 20000 |
| 抽取方式 | 首次全量选择 全量 | 日常同步选择 增量 |
| 增量字段 | 优先自增主键或 updated_at | 字段应建立索引 |
| 调度方式 | 一次性或间隔性 | 一次性迁移用一次性,日常同步用间隔性或 Cron |
| Worker JVM | 数据量大时调大内存 | 避免批大小提升后频繁 GC |
| 目标端索引 | 大批量迁移可评估迁移后再建索引 | 减少写入放大 |
创建普通任务
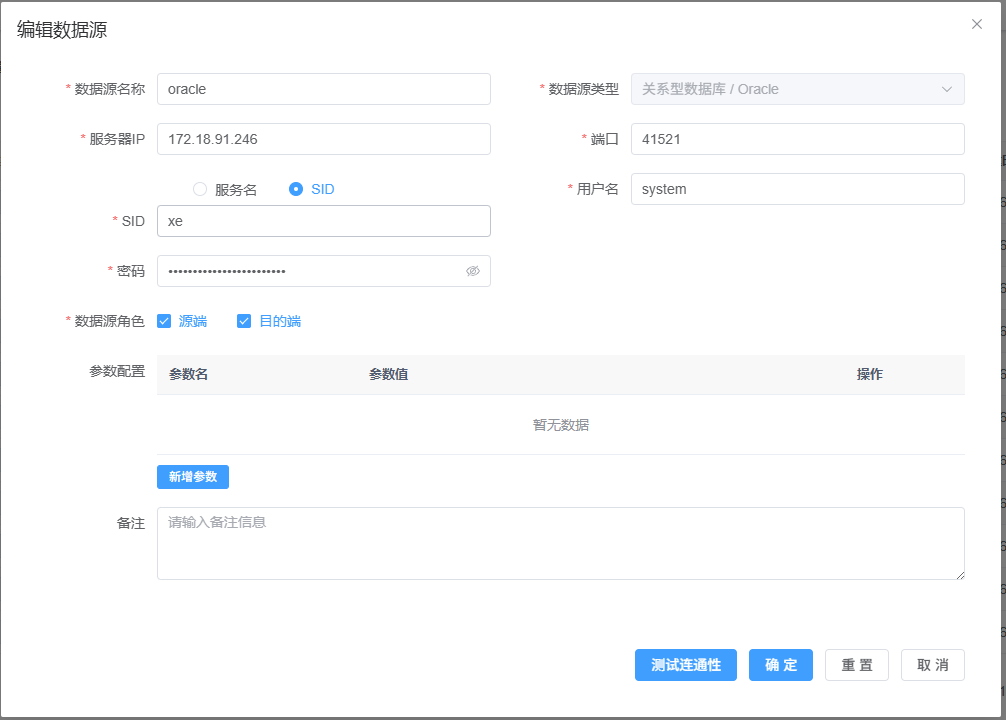
- 添加 Oracle 源端数据源,测试连接通过。
- 添加 PostgreSQL 目标端数据源,确认建表和写入权限。
- 进入任务管理,新建普通任务。
- 选择源端和目标端。
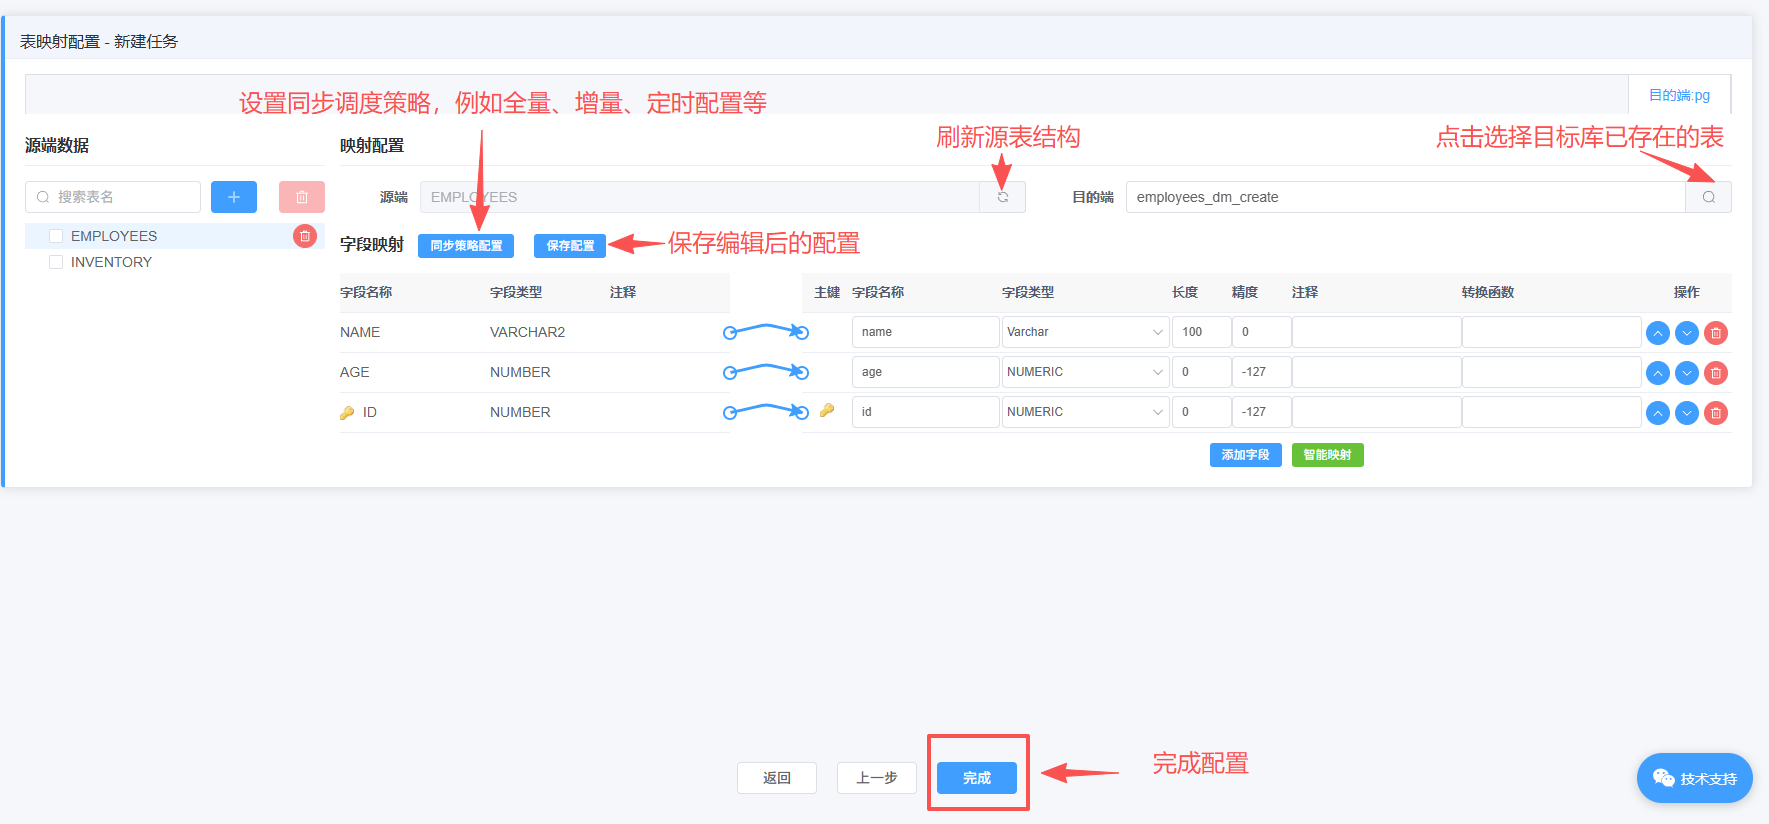
- 进入表映射,选择试迁表。
- 检查字段映射和同步策略。
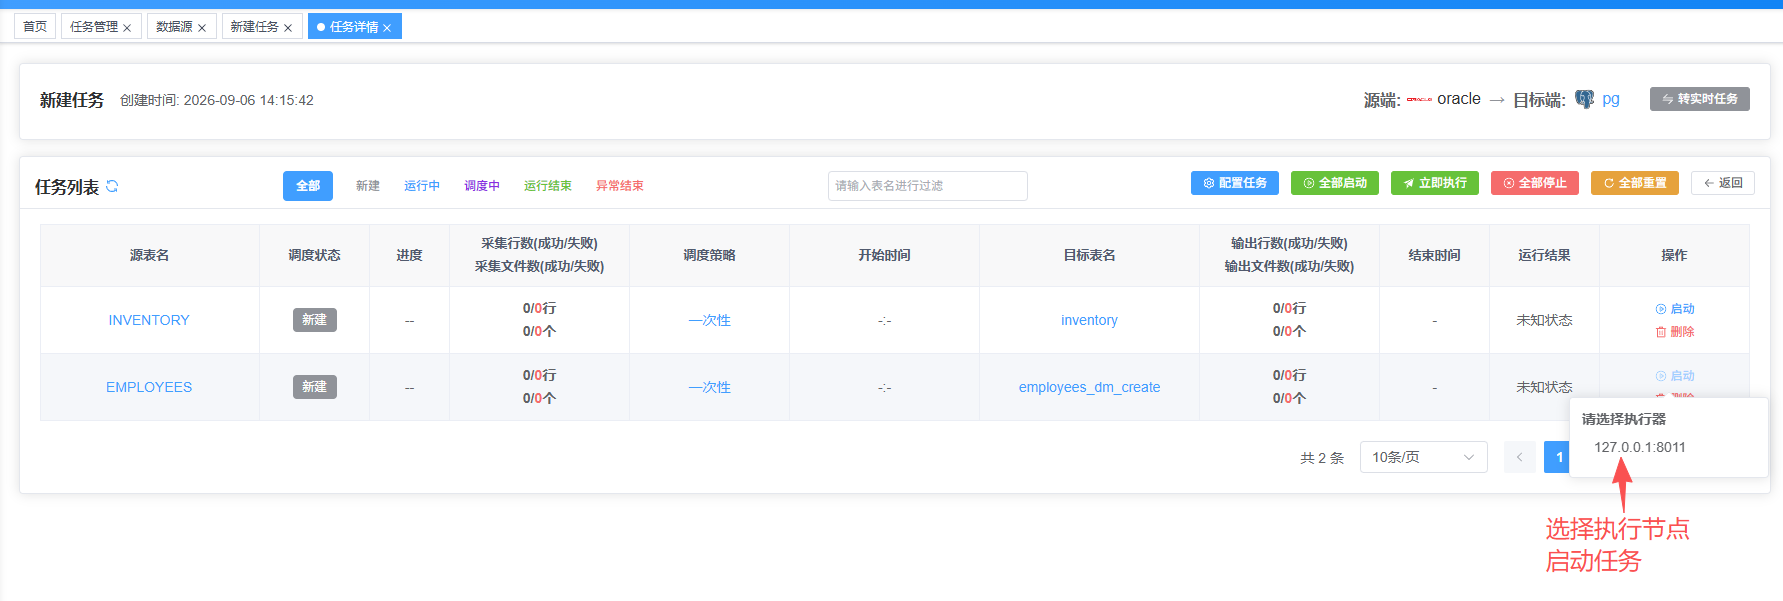
- 保存并启动。
字段映射重点
| Oracle 类型/特性 | PostgreSQL 处理 | 要确认什么 |
|---|---|---|
VARCHAR2(n) | VARCHAR(n) | 长度和空字符串语义 |
NUMBER(p,s) | NUMERIC(p,s) | 金额、费率精度 |
DATE | TIMESTAMP 或日期类型 | 是否带时间、精度 |
TIMESTAMP | TIMESTAMP | 微秒精度 |
| 序列 | 序列或 identity | 当前值是否校准 |
| schema/大小写 | PostgreSQL schema | 表名和字段名是否被正确识别 |
增量字段和 CDC
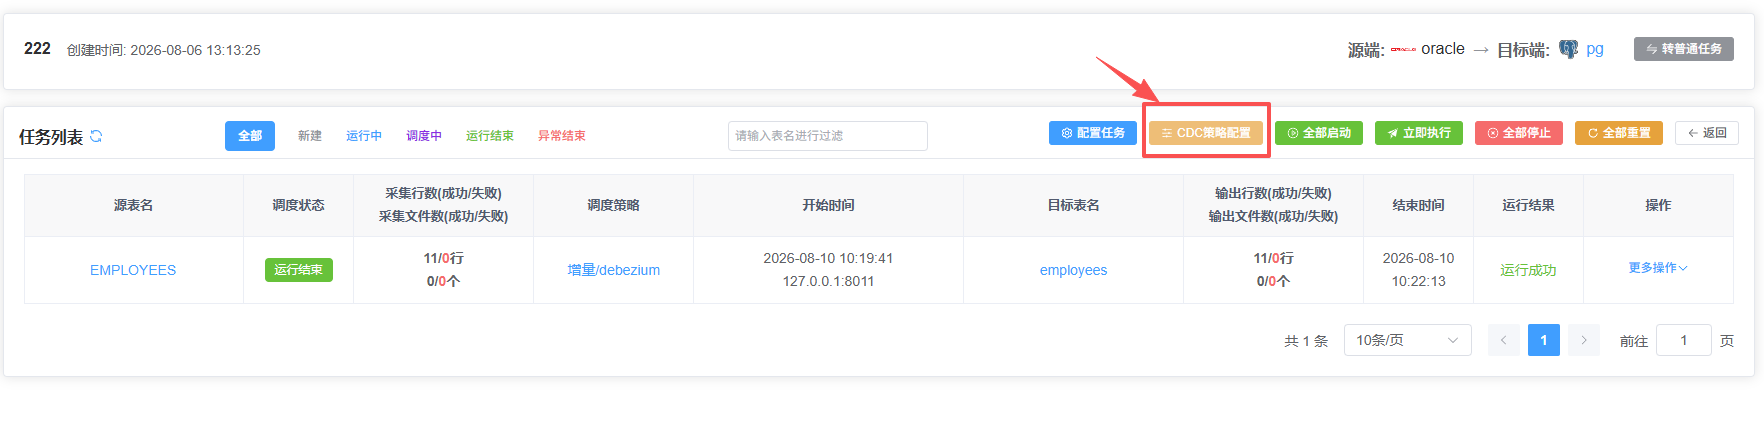
普通任务增量字段只能感知新增和修改,无法感知物理删除。需要同步删除时,使用实时任务 CDC。
CDC 验证重点:
- 快照数据是否完整。
- INSERT、UPDATE、DELETE 是否同步。
- 停止后再次启动是否从位点继续。
- 延迟是否符合场景要求。
结果验证
至少做四类校验:
SELECT COUNT(*) FROM source_table;
SELECT COUNT(*) FROM target_table;

SELECT MIN(id), MAX(id) FROM source_table;
SELECT MIN(id), MAX(id) FROM target_table;

SELECT status, COUNT(*) FROM source_table GROUP BY status;
SELECT status, COUNT(*) FROM target_table GROUP BY status;

SELECT * FROM source_table WHERE id IN (1, 100, 1000);
SELECT * FROM target_table WHERE id IN (1, 100, 1000);
金额表增加 SUM(amount) 聚合校验,时间表增加最小值和最大值校验。
常见坑
行数一致但金额对不上
原因是 NUMBER 精度或小数位不一致。增加金额聚合和抽样校验。
迁移后新写入主键冲突
原因是序列当前值没有校准。全量迁移后查询目标表最大主键,并同步调整 PostgreSQL 序列或 identity。
CDC 启动后没有增量
检查 Oracle 日志/LogMiner 配置、源端复制权限和 Worker 日志,必要时临时打开 DEBUG。